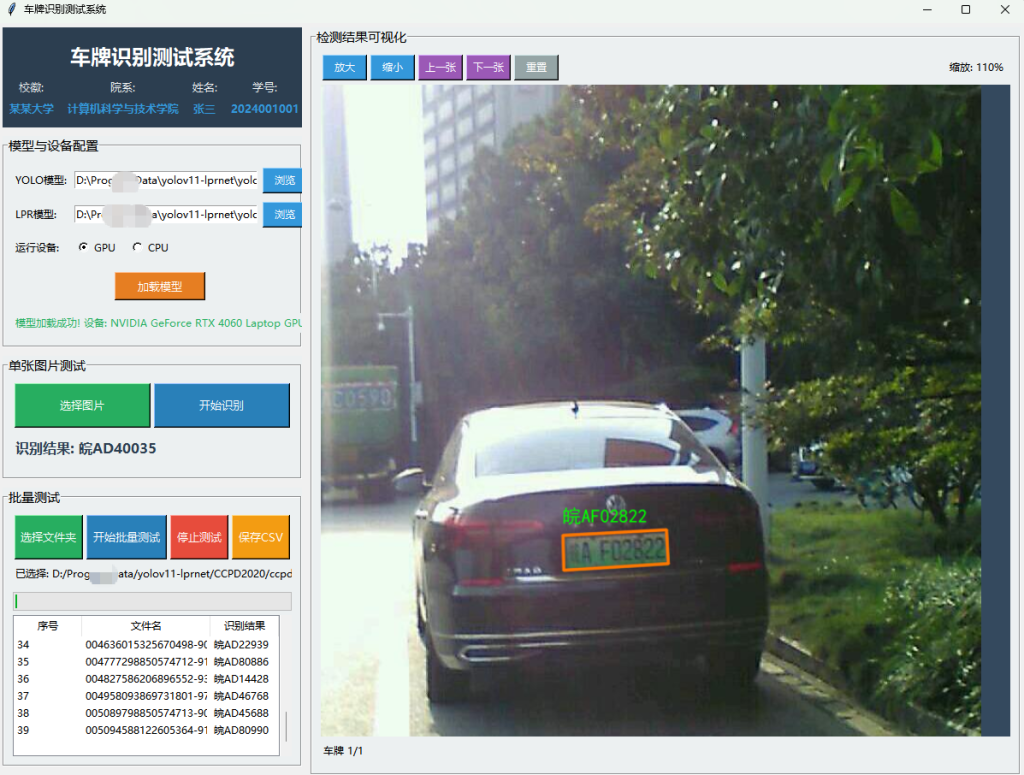
本项目来自GitHub开源项目yolov11-lprnet-ccpd。本项目基于CCPD数据集训练YOLOv11-pose车牌角点检测模型和LPRnet车牌字符识别模型,实现端到端车牌识别。基于Tkinter开发车牌识别系统的GUI界面,可以实现单张图片测试、多张图片批量测试、保存车牌识别结果至CSV文件等等基础功能。
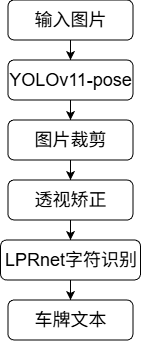
一、项目流程
基于YOLOv11-pose与LPRNet的两阶段中文车牌识别系统:先检测车牌框与四角点,再透视矫正后送入LPRNet进行字符序列识别。
二、数据集介绍
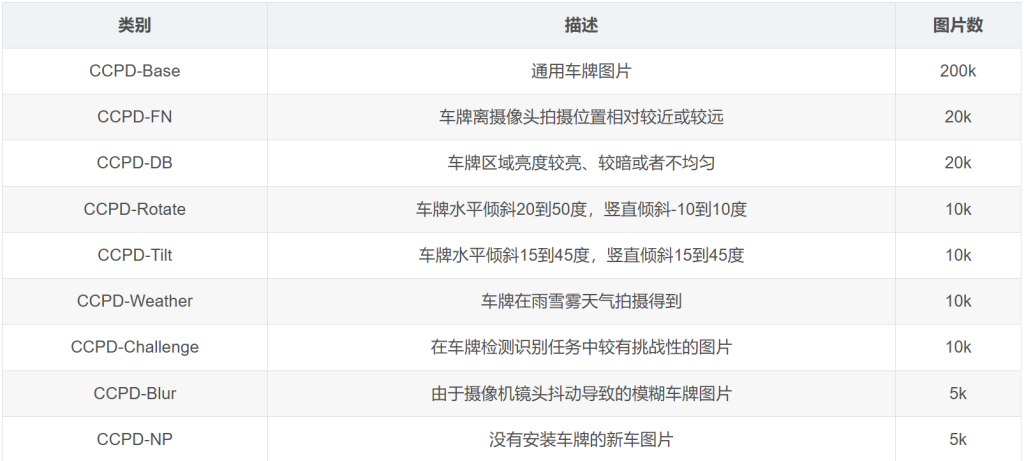
本项目使用CCPD(Chinese City Parking Dataset,ECCV 2018 公开)作为主要数据集。CCPD是一个大型的、多样化的、经过仔细标注的中国城市车牌开源数据集。CCPD数据集主要分为CCPD2019数据集和CCPD2020(CCPD-Green)数据集。CCPD2019数据集车牌类型仅有普通车牌(蓝色车牌),CCPD2020数据集车牌类型仅有新能源车牌(绿色车牌)。数据集包含超过30万张真实停车场场景图像,涵盖模糊、倾斜、旋转、暗光、雨雪、遮挡、新能源绿牌等多种复杂条件。
在CCPD数据集中,每张图片仅包含一张车牌,车牌的车牌省份主要为皖。CCPD中的每幅图像都包含大量的标注信息,但是CCPD数据集没有专门的标注文件,每张图像的文件名就是该图像对应的数据标注。关于CCPD数据集更详细的介绍见其ECCV2018发表论文,地址为Towards End-to-End License Plate Detection and Recognition: A Large Dataset and Baseline。
1.CCPD2019数据集
大小12.26G。包含了25万多幅中国城市车牌图像和车牌检测与识别信息的标注。仅有普通车牌(蓝色车牌)。车牌照片涉及多种复杂环境,包括模糊、倾斜、雨天、雪天等。
下载地址:https://pan.baidu.com/s/1i5AOjAbtkwb17Zy-NQGqkw
密码:hm0u
2.CCPD2020数据集
CCPD2020仅仅有新能源车牌图片,包含不同亮度,不同倾斜角度,不同天气环境下的车牌。
CCPD2020中的图像被拆分为train/val/test数据集,train/val/test数据集中图片数分别为5769/1001/5006。数据集(数据大小865.7MB)。
下载地址:https://pan.baidu.com/s/1JSpc9BZXFlPkXxRK4qUCyw
密码:ol3j
3.数据集的标注和处理
CCPD数据集没有专门的标注文件,每张图像的文件名就是该图像对应的数据标注。
3061158854166666665-97_100-159&434_586&578-558&578_173&523_159&434_586&474-0_0_3_24_33_32_28_30-64-233.jpg的文件名可以由分割符’-‘分为多个部分:
(1)3061158854166666665为区域(这个值可能有问题,可以不管);
(2)97_100对应车牌的两个倾斜角度-水平倾斜角和垂直倾斜角, 水平倾斜97度, 竖直倾斜100度。水平倾斜度是车牌与水平线之间的夹角。二维旋转后,垂直倾斜角为车牌左边界线与水平线的夹角。CCPD数据集中这个参数标注可能不那么准,这个指标具体参考了论文Hough Transform and Its Application in Vehicle License Plate Tilt Correction;
(3)159&434_586&578对应边界框左上角和右下角坐标:左上(159, 434), 右下(586, 578);
(4)558&578_173&523_159&434_586&474对应车牌四个顶点坐标(右下角开始顺时针排列):右下(558, 578),左下(173, 523),左上(159, 434),右上(586, 474);
(5)0_0_3_24_33_32_28_30为车牌号码(第一位为省份缩写),在CCPD2019中这个参数为7位,CCPD2020中为8位,有对应的关系表;
(6)64为亮度,数值越大车牌越亮(可能不准确,仅供参考);
(7)233为模糊度,数值越小车牌越模糊(可能不准确,仅供参考)。
三、项目环境配置
该项目包含YOLOv11、PyTorch、opencv等,显然在Anaconda的虚拟环境下,更有利于项目环境的配置和管理,可以创建新的虚拟环境,也可以直接使用这一篇内容里创建过的yolov11的虚拟环境。
1.虚拟环境配置
若新创建虚拟环境,需要按照requirements.txt文件中的项目依赖项配置。同时,如果要使用CUDA加速模型的训练,还需要下载对应版本的cuDNN、CUDA等,这里不再赘述。
若直接使用已经创建过的yolov11虚拟环境,则项目环境已然搞定,无需其他操作。
2.预训练模型下载
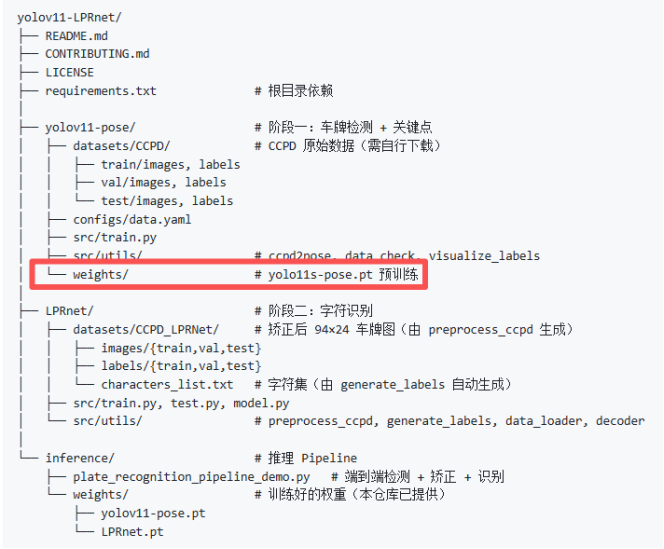
项目中的车牌关键点识别部分是基于yolov11的预训练模型yolo11s-pose.pt,yolo11s-pose.pt下载地址:GitHub – FJsRepo/ultralytics-YOLO11: Ultralytics YOLO11
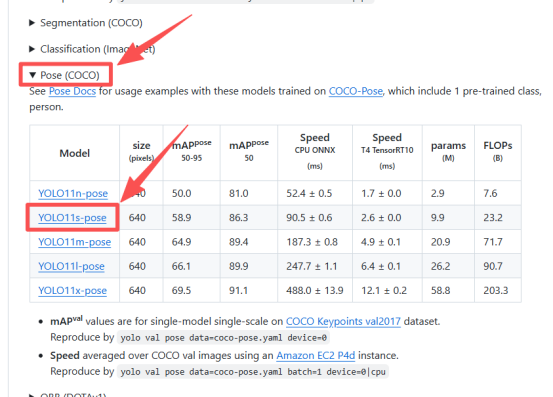
下载完成后,需要将预训练模型放到yolov11-lprnet-ccpd-master\yolov11-pose\weights文件夹下,如下图
四、训练YOLOv11-pose
整体思路首先需要准备数据,将CCPD数据集中的数据转换为yolo格式的数据,并将数据放到对应文件夹下。然后,设置合适的超参数进行模型的训练。
1.完成数据转换
(1)复制CCPD2020中的图片,将train/val/test中的图片分别复制到yolov11-lprnet-ccpd-master\yolov11-pose\datasets\CCPD目录下的train/images、val/images、test/images中。
(2)按yolov11-pose/README.md完成数据转换(ccpd2pose、data_check)。
ccpd2pose、data_check这两个脚本在yolov11-lprnet-ccpd-master\yolov11-pose\src\utils目录下。
修改ccpd2pose.py中的数据集目标地址为自己的数据集目录。
例如我的数据集目录为:D:\ProgramData\yolov11-lprnet\yolov11-lprnet-ccpd-master\yolov11-pose\datasets\CCPD
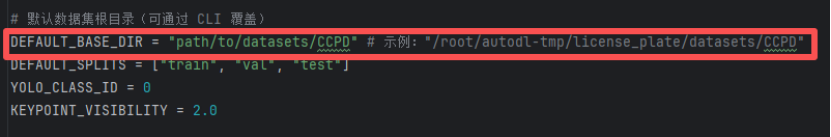
运行ccpd2pose.py文件,即可生成图片对应的labels标注文件。
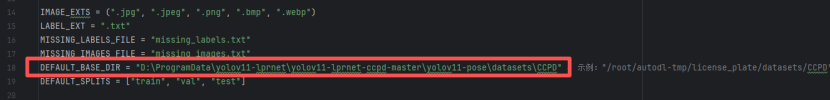
运行data_check.py前,也需要修改数据集目录,如下图。修改成自己的数据集目标地址。
(3)修改.yaml配置
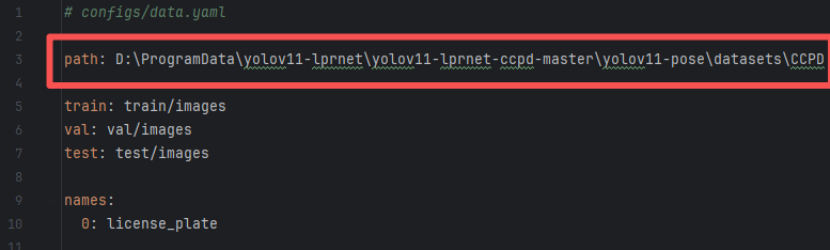
打开yolov11-lprnet-ccpd-master\yolov11-pose\configs目录下的data.yaml文件,修改数据集地址。
2.基于yolo11-pose.pt训练模型
训练脚本在yolov11-lprnet-ccpd-master\yolov11-pose\src\train.py目录下。
开始训练前,需要根据显存大小调整超参数。8G显存为例,DEFAULT_IMGSZ的训练默认值为640,DEFAULT_BATCH的默认值为64,直接训练会爆显存。可以将DEFAULT_IMGSZ修改为416试试。
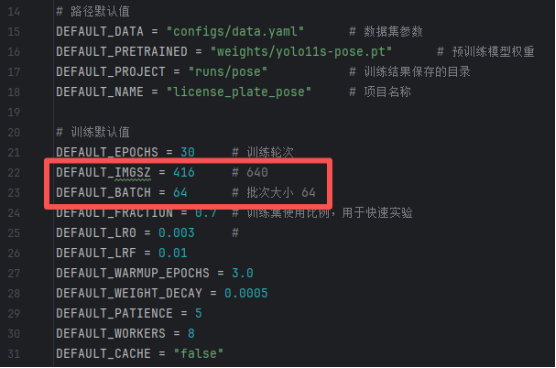
运行train.py完成训练。默认训练30轮次,实际会触发早停机制。
训练结束后的结果会保存在:yolov11-lprnet-ccpd-master\yolov11-pose\runs\pose\license_plate_pose\weights
其中best.pt为验证集上表现最好的权重。
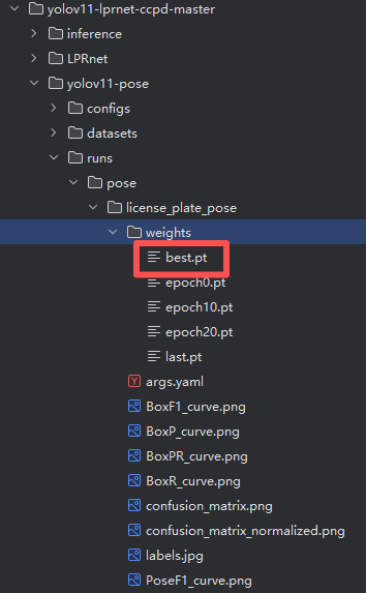
训练完成后,将这个权重best.pt复制到inference/weights/yolov11-pose.pt。同时重命名为yolov11-pose.pt。
五、训练LPRNet
1.数据处理
按LPRnet/README.md完成数据预处理(preprocess_ccpd、generate_labels)。
(1)透视矫正
训练数据由yolov11-pose阶段的CCPD数据生成。preprocess_ccpd.py脚本在yolov11-lprnet-ccpd-master\LPRnet\src\utils目录中。修改脚本中YOLO的数据集地址、LPRnet数据集地址以及可视化图片输出的地址。
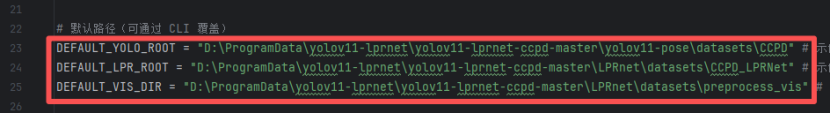
运行preprocess_ccpd.py。

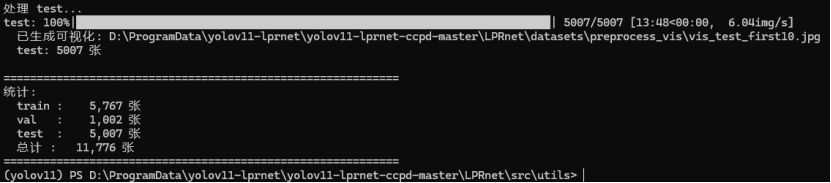
运行完成后下图中的目录中将会出现矫正后的车牌图片。
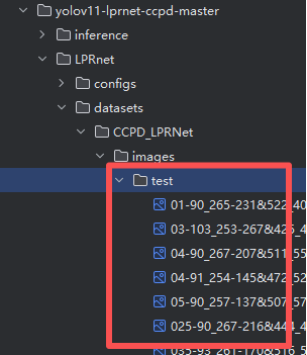
(2)生成标签文件
generate_labels.py在yolov11-lprnet-ccpd-master\LPRnet\src\utils目录中。运行前修改数据集地址。
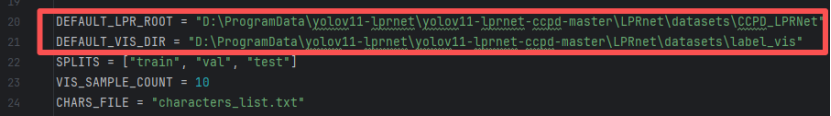
运行generate_labels.py。
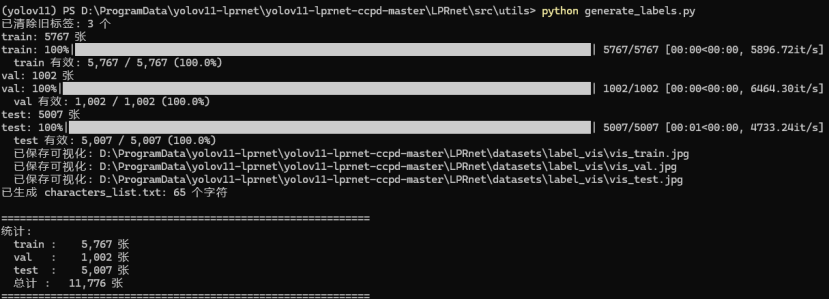
运行结束后下图中的目录中将会出现txt格式的标注文件。
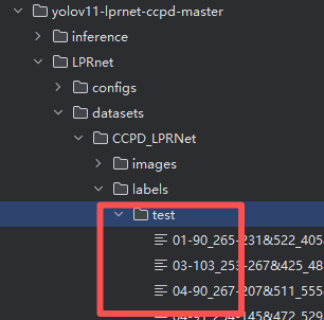
(3)修改.yaml配置
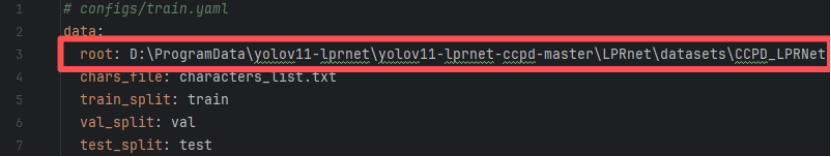
打开yolov11-lprnet-ccpd-master\LPRnet\configs目录下的train.yaml文件,修改数据集地址。
2.训练LPRnet
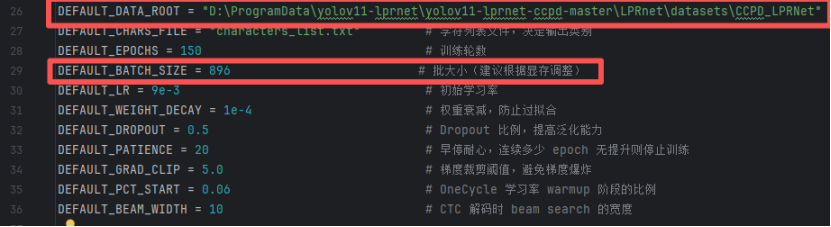
训练脚本train.py在yolov11-lprnet-ccpd-master\LPRnet\src目录下。运行前需要修改数据集地址、训练批次大小。训练批次大小默认1024会爆显存(显存8G会溢出)。
运行训练脚本train.py。如果可以成功运行,大概将耗时4个多小时。
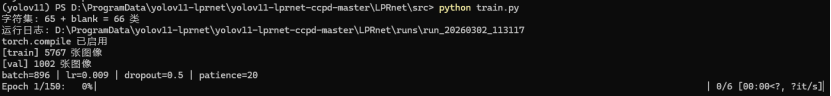
如果使用的是之前的yolov11虚拟环境,可能会报错,大概率会因为两个问题报错,参考第七章遇到的BUG去解决。
训练结束后的结果会保存在:yolov11-lprnet-ccpd-master\LPRnet\weights中。其中best.pt为验证集上表现最好的权重。
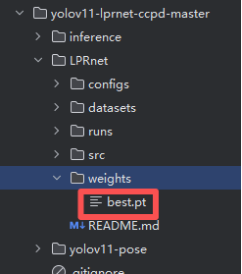
训练完成后,将weights/best.pt复制到inference/weights/LPRnet.pt。同时重命名为LPRnet.pt。
六、使用Pipeline进行端到端测试
测试脚本plate_recognition_pipeline_demo.py在
yolov11-lprnet-ccpd-master\inference目标中。运行前修改测试车牌图片的路径和输出结果保存的路径。
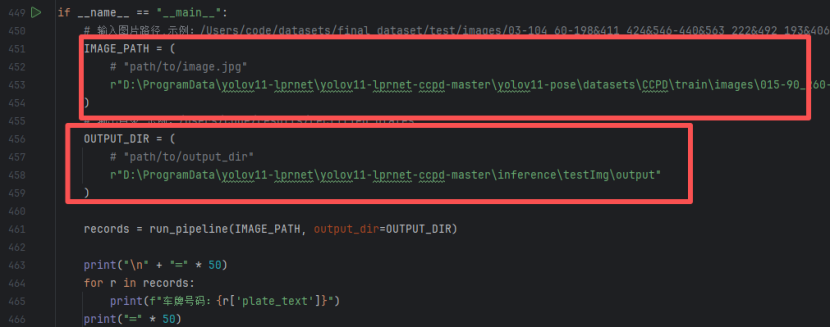
运行plate_recognition_pipeline_demo.py,并查看结果。
七、遇到的BUG
1.color_jitter函数输入参数报错(没截图)
问题原因:应该是torchvision库的版本高了。可以尝试降低torchvision库的版本以解决该问题,具体降低到哪个版本,笔者没有尝试,未知。不推荐用这个方法去折腾。
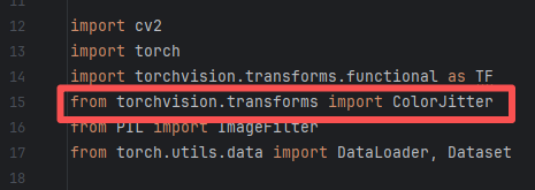
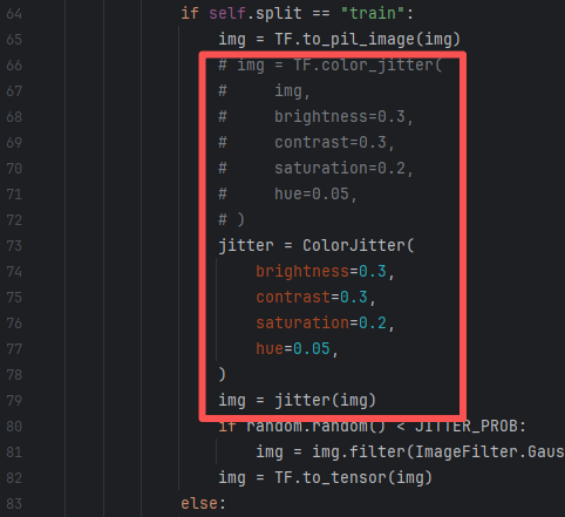
绕开这个BUG,新版本的torchvision.transforms.functional库中,更新了color_jitter函数的使用,只需要修改对应的报错代码即可。
查询报错日志,找到问题代码在yolov11-lprnet-ccpd-master\LPRnet\src\utils目录下的data_loader.py中的第六十多行。
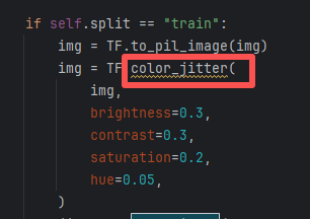
修改步骤:
(1)在data_loader.py的最前面包含新的ColorJitter模块,如下图。
(2)修改六十多行处的问题代码,按下图操作,注释掉旧代码,添加新代码。
2.triton无法自动下载的问题(没截图)
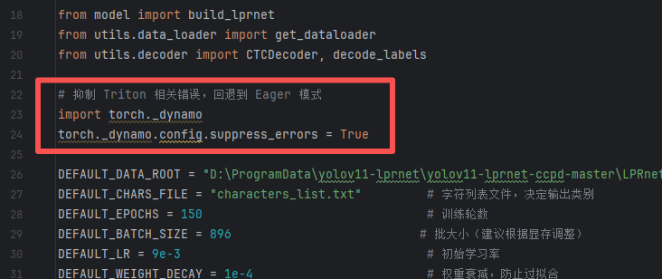
问题原因:torch.compile函数可以优化torch代码,加速模型训练过程。torch库的2.2以后的版本都支持这个功能。代码中检测到你的torch库只要支持torch.compile加速,就会默认开启。但开启后,会因为虚拟环境中缺少triton库而运行失败。
可以尝试解决该问题,笔者尝试在清华源中下载triton库失败,提示没有合适版本。
可以绕开这个BUG,即不使用torch.compile加速。
查询报错日志,找到问题代码在yolov11-lprnet-ccpd-master\LPRnet\src\utils目录下的train.py中。因为train.py中开启了torch.compile加速。
修改步骤:
在train.py的最前面添加下图中的代码,即可关闭torch.compile加速。
3.OSError: [Errno 22] Invalid argument:路径错误
错误解析了路径中的转义字符。将/r,/t解析成转义字符了。在路径前面加个r即可。r”/invalid/path”
4.端到端测试结果差
问题描述:尝试使用训练集中的车牌照片去测试,居然可以识别出多个汉字。查看测试的过程图片生成情况,发现yolo没问题,图片提取很清晰,OCR识别出现了问题。
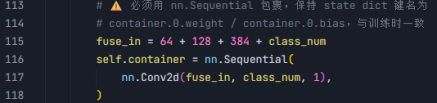
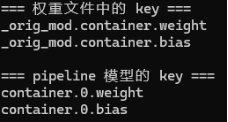
问题原因:端到端测试脚本“plate_recognition_pipeline_demo.py”中,定义的LPRnet有问题。在第113-118行,注释表示必须用nn.Sequential包裹,这个注释错误。用nn.Sequential包裹后的container层的权重key值是container.0.weight,但在LPRnet的模型脚本model.py中,container层没有用nn.Sequential包裹,即在LPRnet训练时保存的权重中,container层的权重key值是container.weight。
增加权重打印的代码,可以明显看到container层在测试管线中权重key值不一样,这会导致测试时模型找不到best.pt中保存的container层的权重,进而加载随机数。所以可以发现错误的测试代码,重复检测一张图片,车牌检测的结果都不一样。
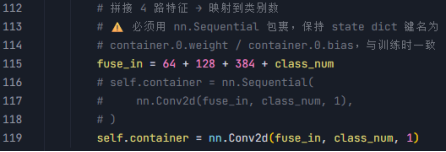
修改步骤:
端到端测试脚本“plate_recognition_pipeline_demo.py”中,第113-118行,container层的定义不要用Sequential包裹就行。如下图所示。
后记
如果您对笔者上述提到的基于LPRNet-YOLOv11的车牌识别项目实战、CCPD数据集、GUI界面等感兴趣,或者想在自己学习过程中有个实际案例做参考,欢迎光临我的面包多主页小尘的橱窗的个人主页,希望对您的学习有帮助~~
参考资料:
GitHub-Auroral0810/yolov11-lprnet-ccpd
[深度学习] CCPD车牌数据集介绍_ccpd数据集-CSDN博客
FJsRepo/ultralytics-YOLO11: Ultralytics YOLO11
OSError: [Errno 22] Invalid argument:无效的参数完美解决方法-腾讯云开发者社区-腾讯云
Python|Windows 系统安装 triton 的方法 – ring军 – 博客园
Torchvision.transforms has no attribute of ColorJitter? – vision – PyTorch Forums